本文由 Arm 首席产品经理 Will Lord 与 Nota AI 首席技术官 Tae-ho Kim 联合撰写
针对不同硬件优化人工智能(AI)模型可能既复杂又耗时。如今,通过 Arm AI Portal 来使用 Arm AI Model Optimizer(Arm AI 模型优化工具),开发者可以:
利用图优化、量化和混合精度等优化技术;
评估并比较性能、准确率和内存需求;
为应用选择适合的配置。
这些面向智能体的工作流让整个过程更简单、更快捷,也让开发者更有信心在从云端到边缘侧的受支持的基于 Arm 架构硬件上,部署更出色的应用。Arm AI Model Optimizer 基于 Nota AI 的 NetsPresso [1]构建,目前已通过 Arm AI Portal 网站上的早期访问计划 (Early Access Program) 提供。
[1] https://www.nota.ai/netspresso
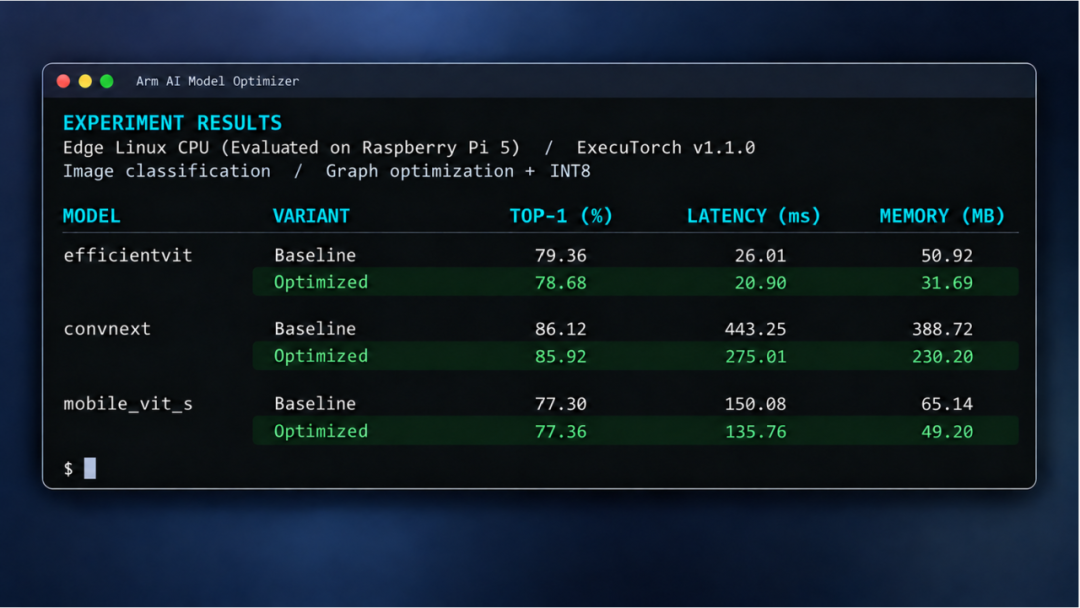
图 1:使用 Arm AI Model Optimizer 优化前后,树莓派 5 上的模型准确率、推理延迟和内存占用对比
更快的处理速度、更高的内存效率:
基于 Arm 架构的硬件,推理速度最高提升 6 倍,内存占用最高降低 74%
初步结果显示,通过 Arm AI Model Optimizer 提供的优化技术,可加快推理处理速度并提高内存效率,同时在一系列工作负载中保持模型准确率和质量:
树莓派 5 上的图像分类:对比优化前的模型,WideResNet-50 的推理速度提升 5.9 倍,内存占用减少 74%,ImageNet Top-1 准确率从 80.82% 变为 80.70%。
Arm 移动端 CPU 上的语音识别:在 vivo X300 Pro 智能手机上,OpenAI Whisper Base 实测解码阶段延迟降低 52%,从 35.63 ms 降至 17.17 ms;在 LibriSpeech 上报告的词错误率保持 4.85% 不变。
面向物理 AI 系统的图像分割:在树莓派 5 上,MobileSAM 的推理延迟降低 23%,从 2,070.63 ms 降至 1,595.46 ms;平均交并比从 0.7309 变为 0.7301。
只需三个步骤即可开始使用:
注册早期访问计划[2],并生成 API 令牌;
安装命令行界面(CLI),并使用 API 令牌完成身份验证:
pip install arm-ai-model-optimizer
按照快速入门指南[3],使用受支持的模型、目标平台和数据集创建工作区和项目。
[2] http://developer.arm.com/ai/tools
[3] https://developer.arm.com/dev-docs/arm-ai-model-optimizer/getting-started/
每项实验都使用配置文件来定义优化步骤和评估标准。开发者可以调整设置、重新运行实验并比较结果,同时保持模型和评估数据一致。
项目设置完成后,即可创建并运行优化实验:
np experiments create --name int8-trial --steps go,gq
cd int8-trial
# Review run.yaml and select quantization and evaluation settings.
np validate
np run --wait
np report
借助 CLI 命令和配置文件,开发者或编程智能体能够以更少的工作量探索更多的优化配置,同时保留对优化目标、评估标准和部署决策的控制权。
Arm AI Model Optimizer 的相关功能也可通过 Arm AI Portal MCP 服务器[4]提供,从而将 Arm 模型、文档和工作流引入开发者已经在使用的编码环境和智能体中。
[4] https://learn.arm.com/learning-paths/servers-and-cloud-computing/ai-portal-mcp/
针对应用所需的硬件进行优化
选择合适的模型只是部署决策的一部分。最佳模型配置取决于应用的运行环境。部署在云端的工作负载,与运行在智能手机、工业边缘系统或嵌入式设备上的工作负载相比,对性能、内存和功耗有着不同的要求。随着应用不断演进,开发者还需要重新考虑不同 AI 工作负载应在何处执行。
Arm AI Model Optimizer 提供了一种更统一的方法,帮助开发者在受支持的基于 Arm 架构的硬件上评估这些不同选择,从而确定合适的模型、优化技术、运行时和目标平台组合。
目前支持的部署方式包括:
Arm CPU:采用 XNNPACK 后端的 ExecuTorch。
Arm Ethos-U NPU:采用 ExecuTorch Ethos-U 后端,并使用 Vela 进行编译。
上述部署的参考评估硬件包括:树莓派 5、Apple M4 MacBook、vivo X300 Pro、AWS Graviton4,以及搭载 Arm Ethos-U85 NPU 的 Alif Ensemble E8。 这些硬件旨在展示所支持评估环境的广泛覆盖,而并非列出所有可用的部署目标。
更明智的生产决策:将自己的数据带入工作流
参考基准测试固然有用,但实际应用的输入数据可能与标准评估数据集存在显著差异。例如,部署在仓库中的目标检测模型所面对的光照、背景和物体尺寸,可能与初始测试中使用的数据明显不同。
借助 Arm AI Model Optimizer,开发者可以将具有代表性的应用数据[5]引入受支持的优化工作流。校准样本可以为量化提供指导,而单独的评估数据集则可以帮助开发者衡量优化后的模型是否仍能满足质量要求。
[5] https://developer.arm.com/dev-docs/arm-ai-model-optimizer/reference/byod-data-formats/#dataset-registration-byod
优化的目标并非只是生成一个体积更小或速度更快的模型,而是要确认优化后的模型是否仍然满足开发者所构建应用的实际需求。
未来几个月,Arm 计划进一步扩展对更多运行时、后端和 Arm 硬件的支持。早期访问计划的参与者还可通过相关活动和反馈渠道提供意见,并对 Arm 接下来的工作方向产生影响。
深入了解性能:部署前评估结果
实验完成并不意味着优化工作就此结束。开发者还需要了解模型发生了哪些变化,以及模型在目标设备上的实际性能表现。
AI Model Optimizer 的 Probe 可视化工具[6]可对优化前后的模型图进行比较,帮助开发者深入分析模型变化,包括算子、量化以及逐层细节。
[6] https://developer.arm.com/dev-docs/arm-ai-model-optimizer/features/visualizer/
实验完成后,可以使用以下命令生成可视化结果并导出优化后的模型:
np visualize --tool probe
np export --level deploy
开发者之后可以按照端侧性能分析工作流,在包括远程设备等可访问的硬件上测量推理延迟,一定条件下还可以测量内存占用。
通过评估报告、模型图可视化和硬件测量结果,开发者可以在部署前综合评估模型表现,从而做出更加充分、合理的决策。
图 2:Arm AI Model Optimizer Probe 可视化工具对比优化前后的模型图,并突出显示算子、量化以及层级性能指标的变化
立即开始使用 Arm AI Model Optimizer
Arm AI Model Optimizer 将模型选型、优化与部署流程衔接起来,为开发者在 Arm 平台上 AI 应用提供所需的模型、工具和工作流,让整个流程更有把握。开发者可以减少处理复杂优化工作的时间,将更多精力投入到打造 AI 应用的差异化优势上。
欢迎加入早期访问计划,通过 Arm AI Portal 探索 Arm AI Model Optimizer,共同塑造未来发展方向!
- 随机文章
- 热门文章
- 普源示波器MSO5072信号完整性测试
- RS-485总线技术规格要求有哪些?
- DEVICENET转MODBUS TCP网关与AB数据输出模块的高效融合方案研究
- 渠道整合几度失败,福特在华缘何又起重组之心
- 无3C标识的充电宝禁登机!还有哪些物品不能带?
- 一手21款迈腾:8万公里正当年,宜商宜家好选择
- 丰田VOXY,外观时尚,配7座+侧滑门,搭载1.8L混动,价格很亲民!
- 乐道 L90 开启预售!电池租用 19.39 万起
- 坦克 300 紫色外观改装,硬派与个性的极致碰撞!
- 沪上装修明灯:5家重诺企业深度解析与业主自护指南
- 1感染甲流后该如何科学调养?饮食起居这样做,感染甲流后该如何科学调养?饮食起居这样做
- 2马克龙去的这所大学,太宝藏了吧!,马克龙去的这所大学,太宝藏了吧!
- 3福州发布公告:吴石故居将封闭施工,展开系统性修缮
- 4北方多地迎来降雪降温天气 各部门联动“战”寒潮筑牢安全防线,北方多地迎来降雪降温天气 各部门联动“战”寒潮筑牢安全防线
- 5城中话债|激活民间投资:让有效率的资本站上C位
- 6“无保护”攀岩真的无保护吗?“无保护”攀岩真的无保护吗?
- 7晚间重磅!又一万亿级券商将诞生 券业并购潮涌
- 8科学家的照片排在董事长之上,科学家的照片排在董事长之上
- 911月份“菜篮子”产品价格呈现季节性上涨 多因素推高生产成本,11月份“菜篮子”产品价格呈现季节性上涨 多因素推高生产成本
- 10何立峰:有力有序有效做好2026年金融重点工作