9月10日,DeepSeek发布并开源新一代原生多模态大模型DeepSeek-V4.1-Flash。摩尔线程基于MTT S5000 AI训推一体智算卡和自研MUSA软件栈,第一时间对接SGLang官方主线,完成模型权重加载、推理服务启动和文本问答验证,并同步支持V4.1-Flash的原生多模态能力。图文混合输入、图像理解、视觉问答等任务均可在MTT S5000上直接运行,实现对该模型的Day-0支持。
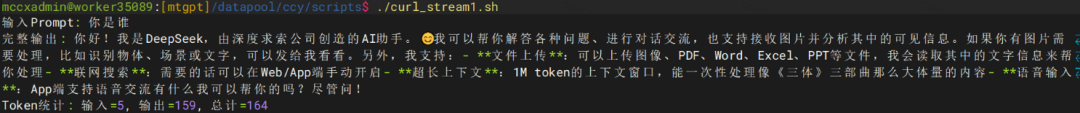
图示: DeepSeek-V4.1-Flash在MTT S5000上的文本问答实测结果
图示: DeepSeek-V4.1-Flash在MTT S5000上的多模态对话实测结果
DeepSeek-V4.1-Flash为552B参数的MoE模型,采用全新的Causal-Encoder-Decoder非对称架构:输入侧激活参数量为8B,输出侧为16B,在兼顾模型能力的同时,有效降低推理成本。此外,模型采用新的预训练方法,并经过更大规模的强化学习后训练;据官方披露,其在多项基准测试中展现出领先表现,在部分核心指标上超过 DeepSeek-V4-Pro等旗舰模型。
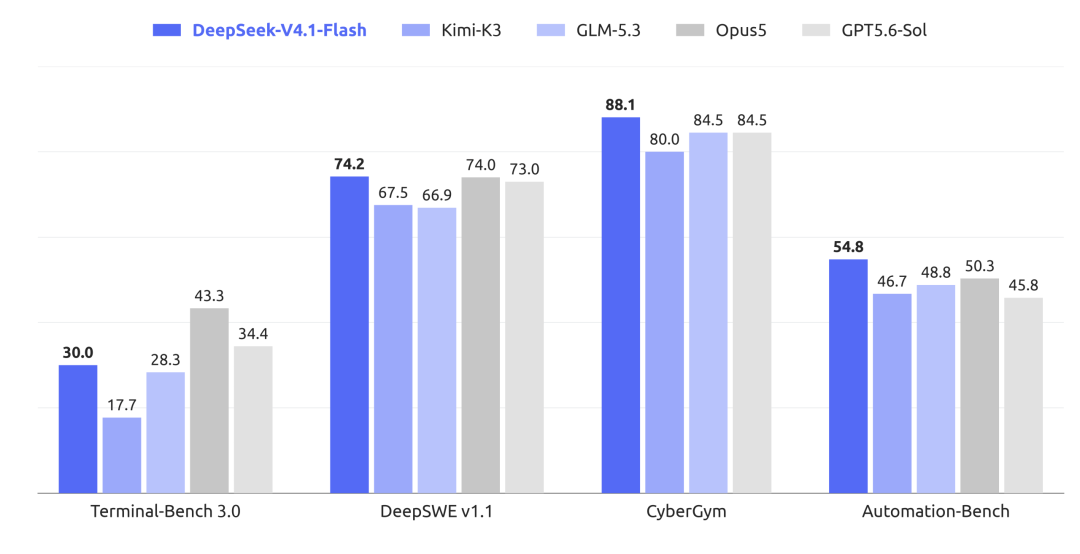
图示:DeepSeek-V4.1-Flash与主流前沿模型在Agentic Benchmark上的性能对比
面向新架构,构建Day-0系统级工程路径
针对DeepSeek-V4.1-Flash的技术特性,摩尔线程围绕硬件算力、软件栈与开源框架进行协同适配,在MTT S5000上形成从模型接入、运行时调度到专用算子支持的系统级工程路径:
基于SGLang官方主线快速承接。
MUSA已成为SGLang官方后端,为摩尔线程快速承接新模型提供了统一入口。针对DeepSeek-V4.1-Flash,团队直接沿用SGLang主线的模型定义、调度逻辑、服务接口和多模态输入处理管线,缩短了从模型发布到服务拉起的周期。目前框架侧已形成从模型入口、运行时调度到MUSA专用算子路由的完整适配链路,模型适配可以更快进入统一、可持续演进的服务体系。
复用既有基础设施,大幅缩短适配周期。
摩尔线程此前已完成DeepSeek-V4相关算子、缓存、通信和运行时等基础设施建设,并在多模态模型适配上积累了视觉编码、图文预处理等链路经验。面对V4.1-Flash,团队复用RoPE、top-k、MoE、mHC等成熟能力,将主要工作集中在新架构差异、关键路径和多模态输入链路的适配上。既有积累使模型迁移无需从零开始,不仅显著缩短了适配周期,也为后续DeepSeek系列模型及其多模态能力演进提供了可复用的工程底座。
多渠道算子快速补齐,持续释放性能。
针对DeepSeek-V4.1-Flash引入的新算子与新路径,无论是文本侧的注意力与缓存机制,还是多模态链路上的视觉编码、图像预处理环节,摩尔线程都以多渠道协同的方式快速补齐:CSA2跟随Flash MLA官方主线快速适配,Triton-MUSA用于快速建立正确性基线,TileLang-MUSA用于持续迭代关键算子性能,MATE则负责统一接口和调度协同。框架、算子与运行时路径相互衔接,确保模型先快速跑起来,再持续完成热点优化,稳步释放模型推理性能。
原生多模态能力同步支持。
除文本推理外,本次适配同步支持了DeepSeek-V4.1-Flash的原生多模态能力。依托SGLang主线的多模态接入路径,以及MUSA软件栈在视觉编码、图文输入处理等关键链路上的适配,模型可在MTT S5000上直接处理图文混合输入,完成图像理解、视觉问答、图表解析等多模态对话任务。
持续优化,释放性能潜力
后续,摩尔线程将持续推进DeepSeek-V4.1-Flash在MTT S5000上的性能演进,优化方向包括:CSA2融合内核、FP4 KV Cache、长上下文内存管理、Engram预取、DSpark调度、MUSA Graph和Prefill/Decode分离等,多模态链路的性能与稳定性也将同步打磨。
随着这些优化逐步落地,DeepSeek-V4.1-Flash在MTT S5000上的性能潜力将持续释放,为开发者提供高效、稳定、易用的国产AI算力支持。
关于摩尔线程
摩尔线程以全功能GPU为核心,致力于向全球提供加速计算的基础设施和一站式解决方案,为各行各业的数智化转型提供强大的AI计算支持。
我们的目标是成为具备国际竞争力的GPU领军企业,为融合人工智能和数字孪生的数智世界打造先进的加速计算平台。我们的愿景是为美好世界加速。
- 随机文章
- 热门文章
- 2025低空技术与工程大会在京开幕
- RS-485总线技术规格要求有哪些?
- 填补中国空白,深圳传感器公司突破多个“全球第一”
- 郑州大学:研究柔性压力传感器中的微形态工程及其人工智能应用
- 技术更新 Linky1& ALXN25:更智能更安全的网络体验
- 工业园区变压器负载超限、电费居高不下?安科瑞光伏监控系统一招破局!
- 从"听见"到"秒懂",Leion Hey2如何重新定义跨语言沟通新标准?
- 耐油橡胶板规格型号有哪些
- 家用充电桩全攻略:安装、成本与使用指南
- 夏日来点冷知识|AIGC科普动漫小剧场:在古代如何过夏天?关于消暑纳凉 古人的脑洞大着呢
- 1感染甲流后该如何科学调养?饮食起居这样做,感染甲流后该如何科学调养?饮食起居这样做
- 2马克龙去的这所大学,太宝藏了吧!,马克龙去的这所大学,太宝藏了吧!
- 3北方多地迎来降雪降温天气 各部门联动“战”寒潮筑牢安全防线,北方多地迎来降雪降温天气 各部门联动“战”寒潮筑牢安全防线
- 4福州发布公告:吴石故居将封闭施工,展开系统性修缮
- 5“无保护”攀岩真的无保护吗?“无保护”攀岩真的无保护吗?
- 6城中话债|激活民间投资:让有效率的资本站上C位
- 7晚间重磅!又一万亿级券商将诞生 券业并购潮涌
- 8科学家的照片排在董事长之上,科学家的照片排在董事长之上
- 911月份“菜篮子”产品价格呈现季节性上涨 多因素推高生产成本,11月份“菜篮子”产品价格呈现季节性上涨 多因素推高生产成本
- 10何立峰:有力有序有效做好2026年金融重点工作